当你向 ChatGPT 提问时会发生什么
内容
你在 ChatGPT 中输入一个问题并点击发送。
一个 JSON 请求体以普通的 HTTPS POST 形式从你的笔记本发出。不管你输入的框是 ChatGPT、Claude、Cursor,还是用 curl 直接调用 OpenAI 的 API,发出的 POST 请求大致相同。几百毫秒后,第一个 token 出现,然后是第二个,第三个。大多数人把这段间隔当作黑箱:文本进去,token 出来。直到你开始关心第一个 token 为何停顿、为什么一个简短回答却收费颇高、或者为什么同一个提示第二次调用便宜而第一次昂贵。
让我们沿着请求穿过整个技术栈追踪一遍,就像那些"当你输入一个 URL 时会发生什么"的帖子追踪一个数据包从键盘到服务器再返回的过程一样。
请求是这样的:
curl https://api.example.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3-8b-instruct",
    "stream": true,
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "Explain the KV cache in one sentence."}
    ]
  }'
下面的每一跳要么是这个提示词本身,要么是从它衍生出的 token。
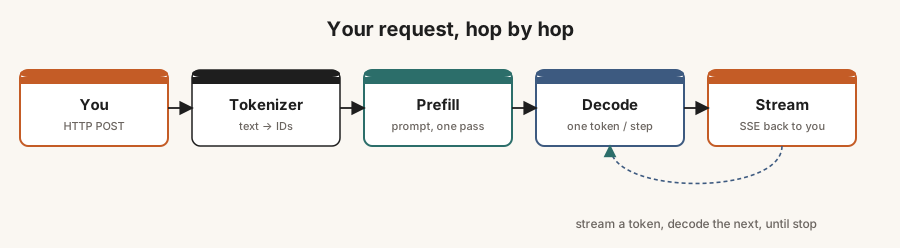
POST 请求离开你的笔记本
请求在发出时加密,到达服务器后像其他付费 API 一样进行校验:密钥是否有效、配额是否用完。然后需要把 "Explain the KV cache in one sentence." 转换成 GPU 能运行的形式。
如果你刚才发送过同样的系统提示词,服务器已经缓存了那部分计算结果,会跳过接下来的一部分工作。第一次则需要全部执行。
对提示词进行分词
一个字节对编码(byte-pair encoding)的分词器,与模型一起训练并在推理时固定不动,将文本映射到一组固定的整数 ID 词汇表。Llama 3 的词汇表有 128,256 个条目。许多生产级模型的词汇表规模在这个 100k–200k 范围内。
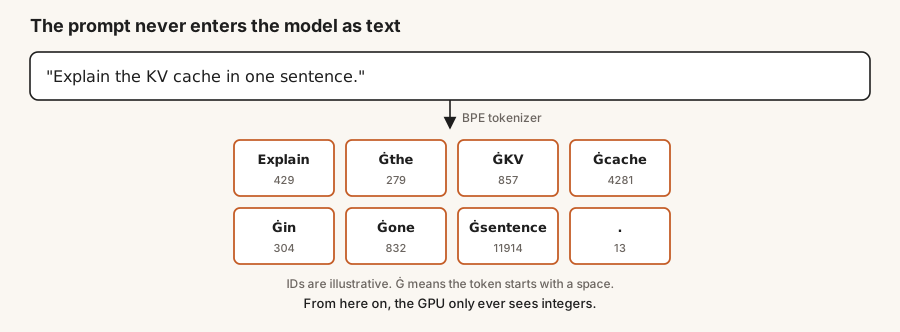
"KV" 可能是一个 token。" cache" 可能是另一个,开头的空格被内置进去。"Hello world" 在某个模型上是 [9906, 1917],在另一个模型上是 [15496, 995]。分词成本很低。但上下文限制、预填充成本、解码成本以及 KV 缓存都按 token 数量计费。
你的系统提示词和用户提示词被拼接起来(加上角色标记的特殊 token),变成一串 ID。假设整个输入是 40 个 token。这 40 个整数就是现在的请求。
将 token 转换为向量
嵌入矩阵完成了这次跳跃:这是模型自身的一个权重矩阵,和其他权重一样在训练中学习,每个 token ID 对应一行。Llama 3 8B 的嵌入矩阵有 128,256 行,与词汇表中的每个条目一一对应,每行是一个包含 4096 个数字的列表。Token 857 通过从矩阵中取出第 857 行变成一个向量。无需计算,直接取值。
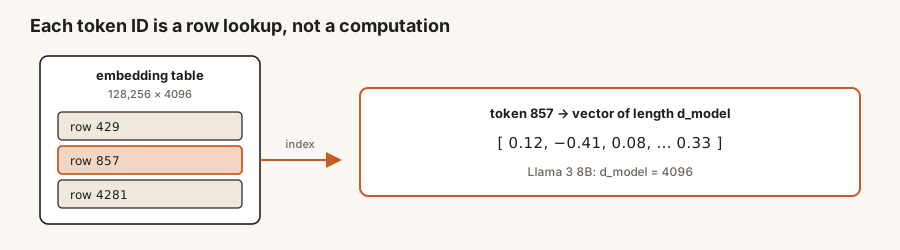
经过这一跳,你得到了一个形状为 [40 × 4096] 的矩阵。这才是 transformer 要处理的内容。
注意力机制与前馈网络,重复 32 次
Llama 3 8B 有 32 层 transformer。每一层对你的 [40 × 4096] 矩阵做两件事:注意力机制让每个位置从其他位置获取上下文,然后前馈网络独立地转换每个位置。堆叠 32 层后,"cache" 的向量已经吸收了 "KV"、"Explain" 以及提示词中所有其他内容的信息。我将在后续文章中深入解释注意力机制和 FFN。
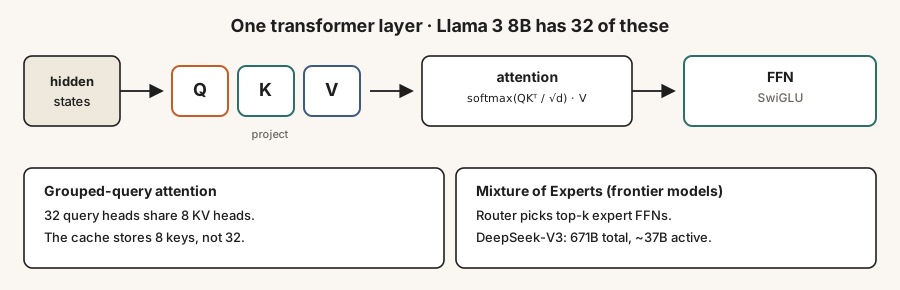
注意力机制将隐藏状态投影到 Q、K 和 V,然后计算 softmax(QK^T / sqrt(d_head)) * V。每个位置从所有其他位置收集信息,按相关性加权。生产级内核(FlashAttention-3、FlashInfer)不会将完整的 N×N 得分矩阵物化,而是将工作分块加载到芯片上的 SRAM 中。一些模型还在部分层使用滑动窗口注意力,所以注意力机制并不总是看完整的提示词。
Llama 3 8B 不像旧模型那样为每个查询头配备独立的 key 和 value。它使用分组查询注意力(grouped-query attention):32 个查询头,但只有 8 个 key/value 头,每 4 个查询头共享一组。更少的 KV 头意味着更小的 KV 缓存,这就是为什么"7B 模型的缓存约 1GB"这条经验法则对这个模型偏差了约 4 倍。
在 Llama 这样的密集模型上,每个 FFN 参数对每个 token 都参与计算。混合专家(Mixture of Experts)模型用多个较小的 FFN(称为专家)替换单个 FFN,再加上一个路由器,它查看每个 token 并只将其发送到选中的几个专家。DeepSeek-V3 总共有 671B 参数,但对任何给定的 token 只有约 37B 参数参与计算,因为其余的属于路由器未选中的专家。这与 Llama 70B 的情况不同,后者的每个参数始终都在使用中。关于路由器实际如何工作的更多细节,将在后续文章中介绍。
经过 32 层后,你的 40 个位置中的每一个都持有一个已经看过所有其他位置的表示。
预填充与解码
此时还没有输出 token。服务器处于预填充阶段:对所有 40 个已知 token 进行一次前向传播,并行处理。这就是为什么一个 1,000 token 的提示词在现代 GPU 上仍可能耗时毫秒级。工作量很大(完整注意力的复杂度在序列长度上是 O(n²)),但它映射到矩阵乘法,而 GPU 正是为此设计的。
预填充完成后,两样东西诞生了:最后一个提示词位置的最终隐藏状态,以及提示词中每个 token 的 KV 缓存。首 token 时间(time-to-first-token),在普通聊天模型上,等于"预填充花了多长时间,加上一次解码步骤"。
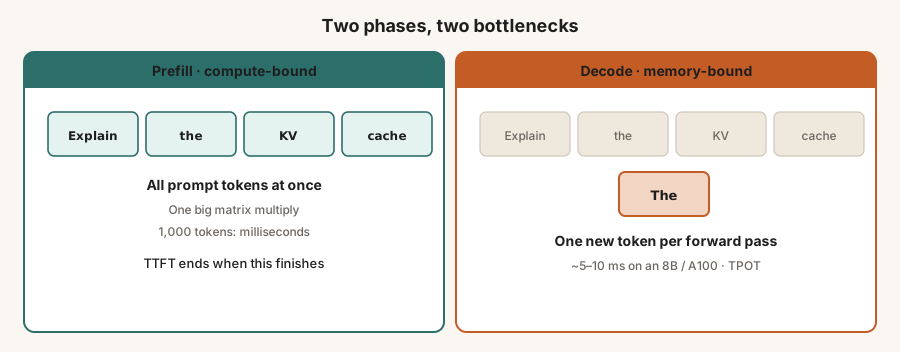
解码是另一个阶段。每个新 token 都是独立的前向传播。只有最后一个位置的输出有意义。对于 A100 上的 8B 密集模型,一次优化良好的步骤大约需要 5-10 毫秒。预填充让张量核保持忙碌。解码则等待 HBM:步骤是读取权重,然后是一次相对廉价的乘法。
这两个阶段如果共享同一块 GPU 就会产生竞争。一个刚到达的 10,000 token 预填充需要大量突发计算;而正在解码的请求只需要微小而稳定的步骤。分块预填充(chunked prefill)是大多数引擎在单个 GPU 内的折中方案:将新提示词拆分成块,与解码交错执行,这样一个大请求不会阻塞所有进行中的流。这是对单个 GPU 的修复。一些服务框架(vLLM、SGLang、Mooncake、NVIDIA Dynamo)更进一步,让预填充和解码各自拥有独立的 GPU 池,在预填充完成后通过 NVLink 或 RDMA 在它们之间传递 KV 缓存。这种传输有成本,所以只有达到一定规模才值得。更多关于这种权衡的讨论将在后续文章中展开。
KV 缓存是下一个 token 成本低廉的原因
没有缓存的话,生成第 N 个 token 需要重新计算前面每个 token 的 K 和 V。一条 500 token 的回复需要进行 O(500²) 的注意力工作,而不是 500 步。缓存存储这些 K 和 V 张量并复用它们。第 N 个 token 只计算自己的 K 和 V,然后读取其余部分。
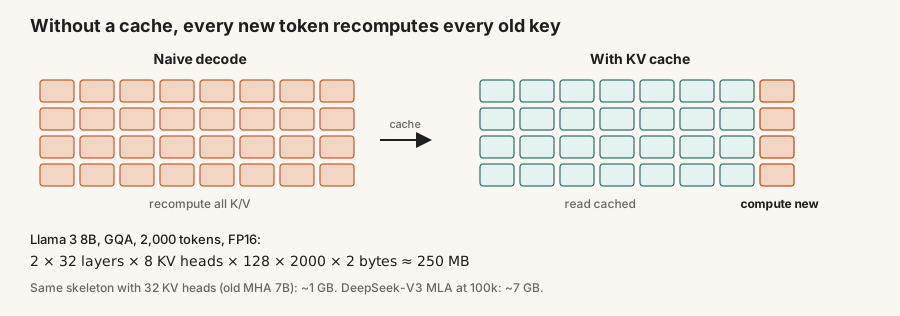
在公式中数 KV 头,而不是查询头:
KV cache = 2 × layers × kv_heads × d_head × context × batch × bytes
Llama 3 8B,2,000 tokens,单请求,FP16:
2 × 32 × 8 × 128 × 2000 × 2 bytes ≈ 250 MB
在相同骨架上使用完整多头注意力的模型约为 1GB,与旧版 MHA 7B 一致。Llama 3 8B 使用 GQA 在 2k tokens 时是 250MB,在 100k tokens 时约为 12.5GB。
DeepSeek 走了另一条路来解决同样的问题,称为多头潜在注意力(multi-head latent attention)。不是为每个注意力头存储完整的 K 和 V,而是先将它们压缩成每个 token 的一个小共享向量,称为潜在向量,然后缓存这个潜在向量。当模型需要做注意力时,它即时从这个潜在向量重建完整的 K 和 V。你在用每个 token 的一点额外计算换取一个更小的东西来存储和从内存读取。在 DeepSeek-V3 上,这个潜在向量是每个 token 每层 576 个数字。跨模型的 61 层,在 FP16 下,每 token 约 70KB,或在 100k tokens 上下文时约 7GB 缓存。如果用普通方式存储完整的 K 和 V,等效的缓存会达到数百 GB。
还有另一种完全不触及模型架构就能缩小缓存的方法:复用。如果 20 个不同的请求都以相同的系统提示词开头,那个共享前缀每次都产生完全相同的 K 和 V 值,所以没有理由重复计算 20 次。vLLM 的自动前缀缓存和 SGLang 的 RadixAttention 都维护一个已计算 KV 块的查找结构,所以一个新的请求如果以你之前见过的提示词开头,可以复用那个缓存而不是再次在上面运行预填充。API 将节省下来的成本以缓存命中折扣的形式体现在你的账单上。这只有在相同的提示词倾向于落在同一台服务器上时才有效,这是一个路由决策,不是缓存决策,而且很容易出错。
模型抽出一个 token
最后一个提示词位置的隐藏状态经过语言模型头:一个从 d_model 到词汇表大小的线性层。你得到 128,256 个 logit。Softmax 将它们转换为概率分布。采样从中选出一个。
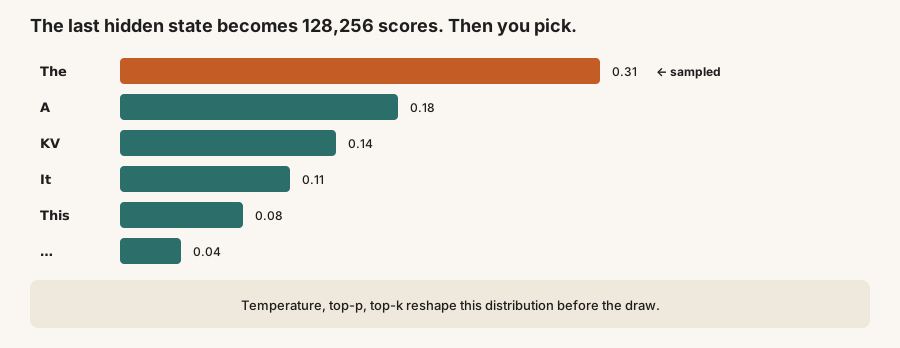
Temperature、top-p 和 top-k 在抽取之前调整分布。常见的 Chat Completions 默认是 temperature 1,top-p 不设上限;nucleus 0.9 是一个覆盖设置。推理模型通常使用较低的 temperature,一些 API 完全放弃这些旋钮,转而使用思考预算(thinking budget)。
假设抽到的是 The。这个 ID 被追加到序列中。你的缓存增加一列。解码再次运行。
那个 token 返回给你
服务器在 The 产生的瞬间就将其写入 HTTP 响应,作为服务器推送事件(或 WebSocket 帧)。你看到一段停顿,然后是一个 tick,然后是又一个 tick。
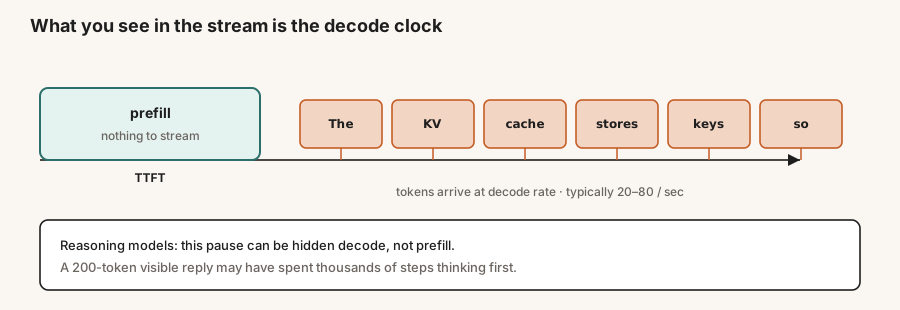
停顿是预填充。在第一次解码步骤完成之前没有什么可以流式传输。之后,token 以模型的解码速率到达,通常每秒 20-80 个,取决于模型大小和硬件。
一个 10,000 token 的系统提示词仍然会产生很长的停顿,除非该前缀已经被缓存。推理模型可能几毫秒就完成预填充,但仍然让你等待,因为它们在解码你可能永远看不到的思考 token。首可见 token 时间不再是预填充的干净代理。一个 200 token 的回答可能轻易耗费数千个计费的解码步骤。
然后一遍又一遍地重复
Token 4 不可能在 token 1-3 之前存在。没有响应内的并行生成。这个顺序税是每个推理优化技巧都在努力克服的约束。循环继续,直到遇到停止 token 或达到最大输出限制。
你最初的提示词"Explain the KV cache in one sentence"可能会得到这样的回答:The KV cache stores precomputed keys and values so each new token does not redo attention over the whole prompt. 大约 20 个 token。在那一次并行预填充之后是 20 次顺序的 GPU 前向传播。
你的请求在 GPU 上并不孤单
一次运行一个请求是浪费的。无论批次是 1 还是 32,权重都要从 HBM 加载。额外的请求分摊了那次读取的成本。
静态批处理等待最长的请求完成。如果你的请求是 20 个 token 而邻居是 500 个,你就坐在填充的等待中。连续批处理(continuous batching)让完成的请求立即释放其槽位。新的预填充可以在你的请求仍在解码时滑入。
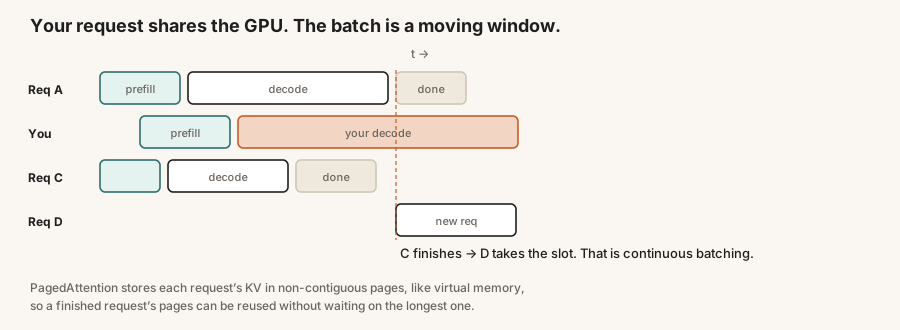
PagedAttention 将 KV 以固定大小的页面形式存储,像虚拟内存一样,这样你就不需要为每个请求预留一个连续的满长度块。完成的页面返回池中。每个严肃的引擎现在都有某种版本的实现。如果某个框架仍在使用静态批处理,那是第一个要改的东西。
如果权重放不下
8B 模型在 FP16 下约 16GB。70B 是 140GB。一块 H100 仍有 80GB,所以 70B FP16 仍需要不止一块 GPU。生产级服务通常不保持在 FP16:FP8,以及 Blackwell 上的 4 位量化,是让 70B 带着缓存还能放下的方式。H200 有 141GB;B200 有 180GB。硬件移动了密集-70B 的分界线。但人们想要部署的模型变得稀疏且大得多,所以你仍然需要拆分它们。
有几种方法可以将一个模型拆分到多个 GPU 上,它们的切分方式不同。
张量并行在 GPU 之间拆分单个层,就像四个人可能抬起一张沉重的桌子,每人各持一角。每个 GPU 处理同一层、同一 token、同一时间,各自完成矩阵乘法的一部分。因为它们同时处理相同的计算,它们必须在每层之后同步以合并部分结果,然后才能进入下一层。这种同步发生在每层、每个 token 上,所以只有当 GPU 连接足够快(NVLink,而不是网线)时才值得,否则通信开销会吞噬节省。
流水线并行是一条装配线而不是一张共享桌子:GPU 0 拥有第 1-20 层,GPU 1 拥有第 21-40 层,一个 token 在接触 GPU 1 之前必须先在 GPU 0 上完全完成。没有层间同步。问题与任何装配线一样:如果管道中只有一个 token,GPU 1 只是坐在那里等待 GPU 0 完成,什么也不做。只有当你有足够的请求流经时才能获得收益,这样 GPU 0 在 GPU 1 完成请求 1 时已经开始请求 2,保持每个阶段忙碌。
专家并行是专门针对混合专家模型的。不是拆分一层或整个模型,而是拆分专家本身:不同的专家驻留在不同的 GPU 上,路由器将每个 token 只发送到持有它选中的专家的 GPU,而不是发送到每个 GPU。如果你在服务一个大型 MoE 模型,你正在做这个,无论你是否有意。
一条捷径:猜几个 token,一次验证
投机解码是生产级框架规避顺序税的方式,它通过加载两个模型而不是一个来实现。除了实际为你的请求服务的大模型外,同一块 GPU 上还坐着一个更小、更快的"草稿"模型。草稿模型自己猜测:它独立地生成 N 个候选 token,成本很低,根本不等待大模型。然后大模型在一个前向传播中一次性检查所有 N 个猜测,而不是自己一个一个地生成它们,因为验证一个 token(给定前面所有内容,这个合适吗)比从头生成一个 token 便宜。它接受它同意的猜测前缀,丢弃第一个不同意的猜测之后的所有内容。你保留的 token 与大模型自己逐个生成它们的质量完全相同,在生成一个 token 的时间内验证了 N 个候选。
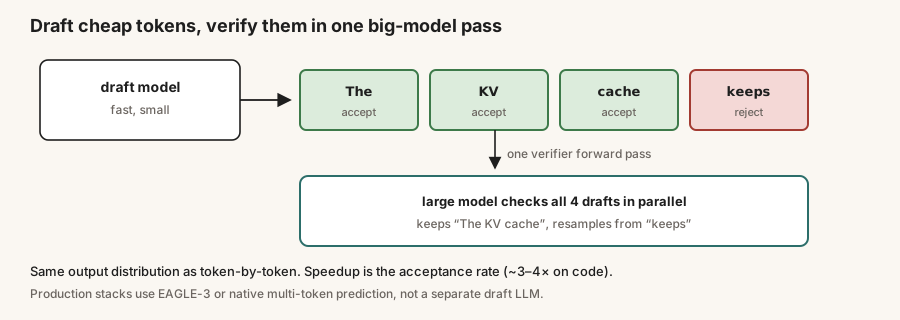
在代码和事实文本上,你可能保留 5 个草案中的 3-4 个(3-4 倍)。在开放式生成中草稿分歧更多,收益缩小。生产级框架通常不附带第二个 LLM。EAGLE-3 在验证器的隐藏状态上训练一个轻量级头。DeepSeek-V3 和 GLM 类 MoE 将多 token 预测内置到基础模型中,所以草稿是一个原生的 next-N 头。
回到你的终端
流结束了。The KV cache stores precomputed keys and values so each new token does not redo attention over the whole prompt. 这就是完整的回复:大约 20 个 token,几百毫秒,而对你来说,它看起来只是文字一个词一个词地出现在屏幕上。
这就是在你的 curl 和那句话之间实际发生的所有事情:提示词被分词成整数,这些整数变成向量,32 层 transformer 将那个矩阵转换成理解自身上下文的东西,一次并行预填充传播同时读取整个提示词,构建了一个 KV 缓存,这样接下来的 20 个 token 不必重做那些工作,然后一个顺序解码循环一次又一次地磨出一个 token,与其他任何人的请求共享 GPU,这些请求可能正在飞行中,可能有一个更小的模型在前面猜测,可能有一个推理循环在思考你永远不会看到的 token。这一切,都是为了一个解释 KV 缓存的句子。这也恰好是一个好的结尾方式:使你的回答成为可能的东西,也正是你的回答所描述的东西。
如果你觉得这篇文章有趣,我很乐意听到你的想法。在 Twitter、LinkedIn 上分享,或者通过 guptaamanthan01[at]gmail[dot]com 联系我。