 中文
53
AI 创业一年复盘:第一次 Build 的成就感,是创业最大的幻觉
佳文共赏
作者: Muji
发表时间:
文章复盘 AI 设计产品 Seede 创业第一年,围绕 agent engineering、AI coding、SEO、数据埋点、文档、分销和组织协作总结实践,指出 AI 加速了构建但放大了维护、治理、权限、质量和交付债务,判断 SaaS 不会消亡,AI native 时代更需要面向长期运行的基础设施与通才型人才。
浏览最新公开文章、摘要与延伸阅读。涌现智元旗下AI信息管理工具
中文文章复盘 AI 设计产品 Seede 创业第一年,围绕 agent engineering、AI coding、SEO、数据埋点、文档、分销和组织协作总结实践,指出 AI 加速了构建但放大了维护、治理、权限、质量和交付债务,判断 SaaS 不会消亡,AI native 时代更需要面向长期运行的基础设施与通才型人才。
 英文
文章系统拆解现代浏览器工作机制,以 Chromium 为主线说明网络加载、HTML/CSS/JS 解析、样式计算、布局、绘制、合成、GPU 渲染、V8 执行、模块加载、多进程架构与站点隔离,并对比 Gecko 与 WebKit 差异,结论是理解这些内部流程有助于优化页面性能、稳定性与安全性。
 中文
作者反思AI提效带来的职业陷阱:高效交付会让员工被视为“手”而非“脑”,更易承接零散执行任务并削弱升职叙事;破局关键不是继续卷产出,而是主动管理与老板之间的奖赏系统,通过判断、取舍和有效pushback提升不可替代性。
 中文
生成式AI把内容生产边际成本推近于零,催生“人类溢价”:消费者愿为可验证的人类创作支付更高价格。美国作家协会认证、Substack订阅增长等显示,人类身份正成为价格信号。但溢价主要流向有品牌和信誉的头部创作者,中间层劳动者被替代,市场将面临分化、认证信任成本和信息鸿沟扩大。
 中文
AI素养源于媒介/信息素养的批判线与计算机/数字素养的工具线,2020年后迅速进入各国政策,但内涵分化明显:中国强调技术主权与四维融合,欧盟转为合规义务,UNESCO突出人的能动性,英格兰和北卡将其嵌入既有课程,韩国因治理焦虑收缩AI教科书部署,结论是国际“AI素养”共识多停留在术语层,能力清单、课程取向和评估基础并未真正对齐。
英文Cursor用语义向量索引与本地稀疏n-gram正则索引协同检索代码:AST切块、自训练嵌入模型、Turbopuffer按代码库命名空间存储,Merkle树只同步变更并提供访问证明,simhash复用团队索引,动态上下文按需读取文件,最终在超大仓库中显著降低首次查询、搜索延迟、成本与Agent token消耗。
 英文
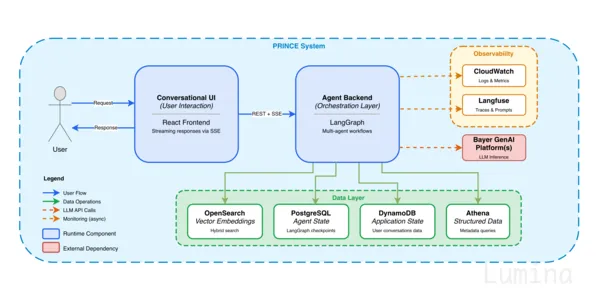
拜耳开发PRINCE,将临床前研究数据从结构化检索升级为自然语言问答和任务执行系统,结合Agentic RAG、Text-to-SQL、多代理编排、引用验证、监控评估、状态恢复和模型兜底,打通PDF报告与元数据,提升数据可访问性、可信度和研究效率;核心经验是生产级智能体不只靠模型,而依赖严格的上下文工程与可控工作流。
 英文
AI已能快速生成代码,但衡量价值不应是“多久做出可运行版本”,而是“多久安全合并”。vibe coding适合低风险探索和原型验证,软件工程则要求责任边界、可审查变更、测试、回滚、运维、合规与长期维护。生成代码若缺乏解释和所有权,只会把成本转移给团队。真正差异不在工具,而在判断力、约束能力和对交付结果负责。