 中文
4
一位从未搬到硅谷的安静法国工程师
佳文共赏
作者: Spencer Baggins
发表时间:
法国工程师Fabrice Bellard及其长期独立开发经历,说明FFmpeg、QEMU、TCC、QuickJS等项目如何成为视频处理、云虚拟化、编译器和运行时基础设施,并展示持续发布高影响力软件、以技术而非营销建立影响的路径。
浏览最新公开文章、摘要与延伸阅读。涌现智元旗下AI信息管理工具
中文法国工程师Fabrice Bellard及其长期独立开发经历,说明FFmpeg、QEMU、TCC、QuickJS等项目如何成为视频处理、云虚拟化、编译器和运行时基础设施,并展示持续发布高影响力软件、以技术而非营销建立影响的路径。
 英文
Dynamic workflows 是 Claude Code 的脚本化多代理编排能力,由 Claude 为任务生成 JavaScript 工作流并在后台执行,适合代码库审计、大规模迁移、交叉验证研究等需要数十到上百代理的任务;用户可通过 `/deep-research`、提示中加入 ultracode、或 `/effort ultracode` 启动,可审批、查看、暂停、恢复、停止、保存为命令并复用;其优势是把计划、分支和中间结果放进脚本而非上下文,提高可重复性、规模和可靠性,但会消耗更多 tokens,并受并发16个代理、单次最多1000代理等限制。
 中文
AdaCoM用外部小型LLM为冻结Agent学习上下文删改、合并与压缩策略,缓解长任务中的上下文退化,无需训练闭源Agent;实验显示网页搜索平均相对提升39.0%,深度研究中Kimi、DeepSeek分别提升9.0%和22.3%,核心结论是强Agent适合保留较长高保真上下文,弱Agent需激进压缩,且策略可在能力相近Agent间迁移复用。
 英文
Perplexity推出Search as Code架构,将搜索栈拆成可由模型生成代码调用的SDK原语,并在安全沙箱中完成检索、排序、过滤、并行和聚合,使智能体能为复杂任务动态构建搜索流程;评测显示SaC在五项基准中四项领先,WANDR领先次优系统2.5倍,同时降低成本和上下文噪声,推动搜索从固定接口转向可编程智能体基础设施。
 中文
Ed Zitron认为AI行业已陷入由OpenAI、Anthropic、NVIDIA、云巨头和风投共同维持的泡沫,核心矛盾是算力承诺、GPU销售、数据中心建设和真实收入之间数学上无法闭合;需求主要由少数AI公司和云厂商互相投喂制造,企业ROI不清、用户增长和利润率恶化,一旦数据中心融资放缓或OpenAI、Anthropic增速不达预期,将引发GPU减值、债务违约、云厂商收入缺口、供应链崩溃和风投清算,结论是AI泡沫不是是否破裂,而是何时以何种方式爆炸。
 中文
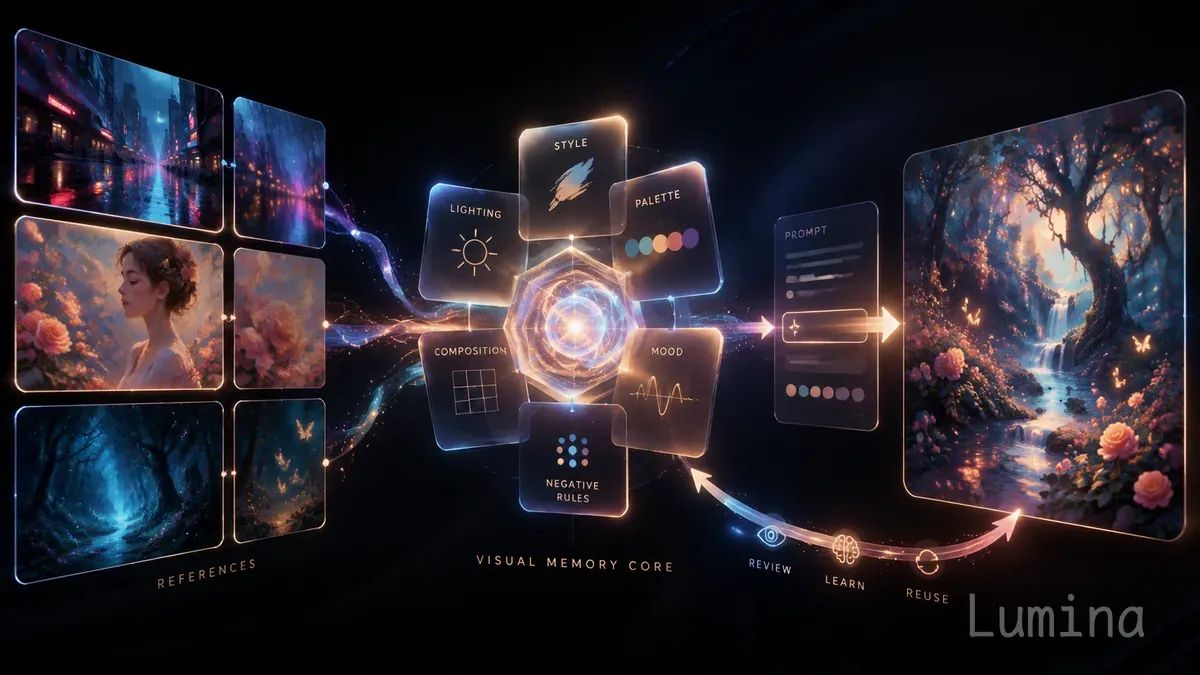
Aether 是用于稳定复用视觉风格的 Codex 插件,可把参考图、提示词想法和生成结果沉淀为视觉记忆,后续自动召回风格、光影、色彩、构图、氛围、角色和负面规则来精修提示词,并根据新素材决定新建、归类、变体或合并,形成可演进素材库;它还记录生成结果、一致性检查和反馈,帮助持续复用有效经验、减少偏差,适合长期保持图片创作风格一致。
 中文
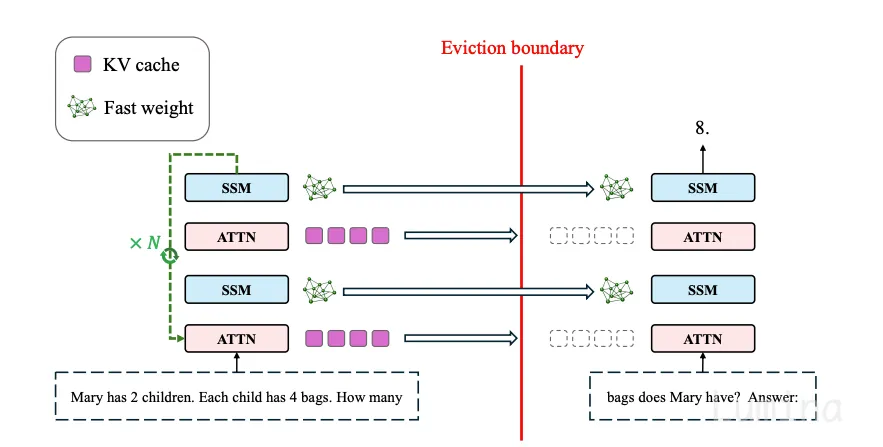
LLM Sleep提出在上下文窗口满后暂停输入,执行多次离线递归前向传播,用学习规则更新SSM快速权重,再清空KV缓存继续预测;其核心判断是长上下文失败主要源于被驱逐信息缺乏足够计算转化,而非内存容量不足。实验显示睡眠循环越多,Rule 110、Depo多跳检索、GSM-Infinite和滑动窗口任务的深度推理表现越好,收益集中在难例;代价是训练成本随循环深度线性上升且更不稳定。